

前編では社内の生産性向上のためのアプリがどうできたか、どのくらい高速に作れたかを紹介しました。
実際に社員の生産性に寄与したこと、そのアプリが短期間で実装され、実装者の負担がアプリの内容に比して非常に少ないことについても説明しました。筆者はおおよそ20年ほどモバイル・Webなどの幅広いソフトウェア開発に関わって現在に至っていますが、この開発速度と品質の両立具合は過去に全く例を見ないものであると言えます。
一方、ここ1年程度のバイブコーディングを通じて、業務アプリケーションを作る中で、はじめからこの生産力と品質を両立できたわけではありません。また仮に、現在の良質なLLMがあっても、どんな人でもそのソフトウェア生成ができるとは考えていません。
この中編では、前編の「舞台裏」について紹介しつつ、現在あるいは近い将来のLLMを用いたバイブコーディングを継続的に成功させるために、筆者がどのように考え、準備し、実際に開発を進めているかという、現在進行系の取り組みをご紹介します。
設定している目標は2つ
社外に対しても共有可能という意味でも都合の良いTaskelなのですが、これ自体は(会社にとっても私にとっても)初めてのバイブコーディング事例ではありません。実際、これまでR&D的な取り組みとして数回、社内で実用水準となりえるようなアプリケーションをバイブコーディングを通じて実装してきていました。
私が取り扱うR&D的な取り組みには、目標が2つあります:
- 有用なWebアプリケーションを構想し、作りきる
- そのアプリケーションをできる限り簡単に「デプロイ」して安定化させる
前者の有用性自体、ハードルが高い問題ではあるのですが、私がより問題意識を持っているのは、どちらかといえば後者(アプリケーションのデプロイを容易にする)です。
バイブコーディングで指示をすると一見してすぐに動作するものを作ってくれるので、ソフトウェア開発の実務から距離がある人ならば「もう完成でしょ」と思いたくなります。
しかし、特に当社の事例のように「複数人で使用する」「業務システムとして運用する」ということを前提とする場合、動いたように見える最初期の「プロトタイプ」ではとうてい完成とは言えません。
場合によっては、登山の五合目にも到達していない。空気が薄くなるのはこれからですよー!!
デプロイの難しさは初期には表面化せず、あとになってから気づく判断ミスとして立ち現れる
試作されたアプリが活用されたか否かについては時の運の部分もありますが、いくらか数をこなしてきた背景があります。ある時、その過程において同じ指示をする局面があることに気づきました。
具体的には、バイブコーディングを担うAI・LLMがいつも似たような落とし穴に陥ってしまう、そして、それを後で(まぁまぁ時間をかけて)指示し直して挙動を補正し直して時間を浪費しているのです。1回しか開発を行わないなら気にもなりませんが、数回やるなかで同じ指示し直しが必要になるなら、さすがに気づきます。
例えば、以下のようなところが典型的に「記述し直し」が発生しやすいようでした:
- 社内のSSOと連携してほしい時にしてくれない。してくれるにしても、その連携の仕方がアプリごとにいつも変わる
- 社内インフラにデプロイする際に、その設計からインスタンス名に至るまで名前が微妙に変わって管理がしづらくなる。そもそも使用する基礎技術がブレる
- 採用するソフトウェア技術(プログラミング言語・Webフレームワーク・Webフレームワーク上の設定など多様なレイヤ)がまちまちになり、最終的に同じ操作感に行き着かなくなる。同じWebフレームワークでも設定ファイルで用いる命名規則がズレていく
- 動的ファイルの管理で、社内で標準的になっているGoogle Cloud Storageとは別の、例えばFirebaseを採用して運用体系が崩れてしまう
いろいろなソフトウェア提供の障害があるのですが、その中でとりわけ困るのが 「他の人に広く試してもらう」段階の壁が厚い・提供時の摩擦が大きいことです。使ってもらおうと思った段階になってソフトウェアの基礎的な部分に深刻な問題が判明して、思わぬ大幅な実装見直しがあったりします。バイブコーディングなので一瞬かと思ったらそうでもない(単一の指示ではなく、設計の見直しも含めた大改修になっている)。
正直に申し上げて「最初に考えといても何の問題もないのに、なんで考えておかなかったんだろう」と思うことがしばしばありました。
面倒なことを先に考えたくない理由を我々は「知って」いる
同時に「アプリケーションを開発する際に最初に考えない」理由を、実は私自身も知っています。見て見ぬふりをしているだけ。
作っている人ならなんとなくご想像できる通りで「最初のプロトタイプを考えているときには、プロトタイプで実現したい機能以外のことを考えたいと思っていない」のです。
この手のバイブコーディングで作り始めるアプリケーションは当初、規模が小さいことが大前提にあります。少なくとも開発初期には、達成したいユーザー体験の構築に目がいくのは当然でしょう。要するに「すぐに作って使ってみたい」のです。
そういうときに、後から発生する運用上のものごとを念頭に置いておくのは、論理的には正しくても、単に楽しくありません。また「楽しいか」だけにとどまらず、利用のイメージが湧かない場合には、本番運用など起きようはずもないことを考えるのは「生産的」とも言いがたい。
プロトタイピングは高速であるべきで、その過程で人は想像できる範囲で成功の期待値が最も高いアプリケーションを作りたがります。私もです。そういうときにはシステム制約の議論は脇においておきたくなる。
アプリケーションでは「使い勝手」の調整が全て。Taskelでも前編の思想は全部こんな話ばかりだったかと思います。
「面倒なことを先に考えない」ことでプロジェクトが丸々停止してしまった事例を目にした
こと私のケースで言えば、面倒な判断を放置しておくことで発生するやり直しは、「非効率」で済む範囲ではありましたが、それよりもより重い問題に至った事例も目にしています。既存の業務システムの一部をバイブコーディングで自前アプリ化しようとして、途中で停止してしまった開発プロジェクトを社内で目にしたのです。
そのプロジェクトでやりたいことは、社内で行われているある典型的な問合せ業務のアプリ化でした。担当者はその業務に慣れているはずの方々です。議事録に記載されている要件(要求?)は、決して小さい規模ではないものの、個別には理解できる内容です。言い換えればキチンとアプリ化するための業務情報を整理している。全体的に好感を持てる整理内容でした。
ただし、プロジェクトの停止に至った遠因もなんとなく推察できました。ソフトウェアをデプロイするイメージがついていない中で、その部分を先に考えないで進めようとしていたのです。控えめに見ても、これまで記述したような「デプロイや社内で共用することに関わる細かな社内事情の考慮」が十分ではないように読み取れました。
「再開の芽が一切ない」というほどではないのですが、再開への障害は、私がバイブコーディングで出会った少々の非効率で済みそうもありません。雰囲気としては「ちょっとした一時停止」というよりも、より深刻な状況、強いて言えば「頓挫」に近い。
このプロジェクト以外にも類似の事例を見聞きしますので、今回に限って特別ということでもなさそうです。もちろん、つまずく原因は厳密にひとつではないのでしょうが、それにしても開発が停止して先に進めなくなるという状況について検証する価値があるように思われました。
この記事ですでに登場した表現に直すと「他の人に広く試してもらう」段階の壁に対する手当が十分ではなかったことが、原因の大きな割合を占めるように(少なくとも私には)読み取れています。
特に、明らかに「良くない」と見て取れるのが、LLMが提案したとされる技術選定の中身です。当社のインフラや運用に関する前提を踏襲していないものが混ざってしまうのです。運用に関わる我々RSSとしては「それは当社の運用ルールに基づかない」という指摘をせざるを得ません。理想的には、運用ルールを先に把握しておき、その理解を踏まえて指示を出すというのが正解のようです。
一方で、運用ルールというのは会社に山ほどあります。「どの運用ルールが開発において有効か」という選定がその瞬間に入るので、実際には準備なしで非開発者がスラスラと指示できるものではありません。さきほど「再開への障害が非効率で済みそうもない」と述べたのはまさにこの部分で、光明が差す余地が見いだせないからでした。
これは、私がこれまでバイブコーディングの折に出会ったのと同様の問題であると言えそうですが、帰結はより望ましくありません。同時に、なんとなくご想像いただける通り、私の非効率な所作を修正する仕組みを構築しきれたなら、その仕組みを通じて別のプロジェクトでは頓挫するリスクを回避できる可能性があることも示唆しています。
コンテクストに守りを先に仕込む
Taskelの事例は、前編では「相対的に低コストで社内で歓迎されるアプリが開発された」という事例でした。これからは目標の2つめの部分にフォーカスします。「業務で試用されるまでの距離を最短化するコンテクストをはじめに用意しておく」という点で、個人的には過去の自分のチャレンジとは異なるアプローチをしています。
先にこれまでの成果の集積である枠を用意しておいて、そのなかで「作りたいものについて指示する」ところだけに特化できないか、ということを考えました。
主張が一見大仰ですが、実はやっていることは蓋を開けると素朴に見える部分のほうが多いと思います。例えば、設計判断上、重要なコンテクストとして個人的に導入したのが以下です:
### 想定されるシステムの規模

日本国内限定で、概ね100人規模の組織で使用される想定で当座の設計・実装を行います。

現時点では大規模化に向けた設計を行なう必要はありません。RSSの目安となる社員数が100人で、レイスグループ全体としてもここは1万人くらいですので、eコマースサイトのような規模の諸々は当然不要です。バイブコーディングを行なう対象業務が、例えば工場の基幹システムということは当社ではありません。我々は銀行系システムを作るということもないし、ましてや24/365が期待されてかつCDNも要求されるような大規模B2C事業をしているわけでもありません。バイブコーディングを任せるLLMがこのような社内の事実を最初知らないことを考えれば、書いておく価値はあるのです。
ここで、この手の「言われてみれば当たり前だが、LLMはそれを知らない条件・制約」を記載せずに「欲しいアプリ」についてだけを記述すると、どちらかといえばB2CやWebの公開事例に基づいたインフラ・設計に自然に寄りかかった提案をしてくることが増えます。それが、全世界の情報をかき集めて構築されたLLMのモデルなればこそです。
当社内のWebアプリの開発者が提案されたものを見たなら、その違和感にはすぐ気づくことでしょう。私も気づきます。バイブコーディングでは「生成されたコードを指示者が見ない」ことが状況に拍車をかけてしまい、かなり後になってから「その前提はどこからきた!?」とびっくりしてしまうような、不必要なほどの重厚長大な設計を放置してしまうことがしばしばです。
以上は外部の方に分かりやすい典型例で、これ以外にも、例えば社内で使われる際の認証・認可の手法(開発環境と本番環境でどう違うか)、使うインフラ(Google Cloud内のPaaSを基本に考えるなど)の制限なども考えれば、まぁまぁの記述量のコンテクストが必要になります。この判断軸の明示の有無がまず、アプリケーション全体の着地を想像以上に左右します。
そこで、「インフラ」的なプロンプトをとにかく Claude Codeの標準のコンテクスト構築ルールに則って「開発者」から見えないところで支える方式として、アプリを作る「開発者」としての自分はただただ「やりたいこと」を書くだけにする、というはっきりとした二層構造となるようにAI向けの指示体系を設計してみることにしました。
以下でおいおい述べる通り、今回の取り組みではこの二層構造は厳密にはできていない部分があります。しかし、それでも十分な効用があるように感じられます。何より、Taskelはデプロイでコケることはなく、結果的にはRSS内で速やかに受容されました。
2つの目標に照らすと、次のような形で両方について一定の評価を行えるということになります。
- 対象となる社員のタスク管理を容易化する有用なWebアプリケーションを作ることができた
- そのアプリケーションの試用してもらう上で「デプロイ」が邪魔にならないようにできた
Taskelのコンテクスト設計を追いかける
ここからしばらく、Claude Codeが読み取れる形式でどのようにTaskelのコンテクストが作られているかを説明します。
Taskel流儀のファイル群
Claude Codeの基本として、常に CLAUDE.md がAIエージェントによって読み込まれることになっています。用途の異なる機会であっても頻繁に読まれることからこのファイルを肥大化させるべきではない、というのが昨今の CLAUDE.md における基本的な使い方です。
そこで、TaskelにおいてもCLAUDE.mdは100行未満、重要な情報についての相対パスを渡し、一部のファイルについてはその読み込む条件を記載するに留めています。以下にその相対パスの一部を示します:
- `CLAUDE.md` ... AI 関連の全体に関わる指示を記録する

- `README.md` ... 主に人間がこのプロジェクトを把握して使い始めるまでにまず参照するファイル

- `requirements/` ... このソフトウェアシステムに関する要求事項を並べた資料を保持する

- `docs/report-guideline.md` ... 本プロジェクトで作業指示・記録を残す際のガイドライン

- `docs/todo-guideline.md` ... `.ai/todos.md` と `.ai/done.md` の使用方法に関するガイドライン

- `docs/test-guideline.md` ... 開発時の一連のテスト(ユニットテスト・結合テスト・E2Eテスト)に関するガイドライン

- `docs/auth-guideline.md` ... 実装するシステムが備えるべき認証認可機能に関するガイドライン

- `docs/ui-design-guideline.md` ... WebフロントエンドのUIデザインに関するガイドライン

- `docs/app-log-guideline.md` ... アプリケーションログ出力に関するガイドライン

- ...

- `backend/` ... バックエンドのソースコード

- `frontend/` ... フロントエンドのソースコード

- `.ai/` ... サブフォルダ内のファイル含めて全体的にAI駆動開発・バイブコーディングに関するファイルを収録する

  - `.ai/design.md` ... このソフトウェア全体の設計。ソースコード全体を読み込まなくても全体感を把握できるように存在する。

  - `.ai/todos.md` ... 作業リスト

  - ...

  - `.ai/logs/` ... タスクに対する作業記録を保存するフォルダ
.ai/は特にTaskel固有のものです。正直に申し上げて不格好なのですが、役に立っているので紹介しておきます。前編で登場した「だいたい全部指示を記録している」 というのは.ai/logs/ フォルダ内の「リクエストファイル」と呼ばれるただのMarkdownファイルのことです。
これらを紹介後、 CLAUDE.mdでは後述する requirements/ , .ai/design.md, .ai/todos.md の意味合いと指示を受けた場合の判断を数十行日本語で説明しています。
「開発フェーズ」という考え方と、それを推進するClaude Codeのスキル群
CLAUDE.md に加えてClaude Code にはスキルという仕組みから定型的な指示をパターン化して実行する準備が整っています。そこで、Taskelでは当初からおおむね以下の4つのスキルを元に開発指示するようにしていました。
- design-and-todos … requirements/phaseN.md からPhase Nのソフトウェア設計と作業リスト一覧を作成する
- 主に .ai/design.md と .ai/todos.md が新しいPhaseに向けて更新される
- impl-phase-local … 上記で作成された作業リストを元に実装し、ローカル環境 (Docker Compose環境) で利用可能にする
- .ai/todos.md にあるチェックリストを消化するイメージ
- deploy-to-cloud … Google Cloudへデプロイする(Terraform込み)
- consolidate-phase … Phaseの終わりとして作業リストや記録を整理して次のPhaseに備える
- .ai/design.md と .ai/todos.md をスッキリさせて次に備える
CLAUDE.mdの内容と上記のスキル、.ai/ 配下のファイルはそれぞれTaskelの開発においては分かちがたく結びついており、開発者はその関係を理解した上で、次のように所定の操作をファイル保存とスキル指示によって繰り返します。
- requirements/phaseN.md に「その開発フェーズで達成したいこと」を記述する
- 基礎的な要求事項を requirements/fundamentals.md へ記述する
- 開発フェーズ毎により具体化した内容を requirements/phaseN.md へ記述する
- design-and-todos スキルを実行する
- 設計 .ai/design.md(の変化)から意図していない大きなソフトウェア設計の決定や変更がないかを俯瞰する
- 作業リスト .ai/todos.md と前述の設計を両睨みして「自分が実装する際と大きな違いがないか」を確認する
- impl-phase-local スキルを実行する
- 作業結果がローカル環境で動作しているかを人の目線でチェックする
- deploy-to-cloud スキルを実行する
- 作業結果がクラウド上でも動作しているかを人の目線でチェックする
- consolidate-phase スキルを実行する → その開発フェーズは終了
実際には実装フェーズの合間に requirements/phaseN.md から考慮抜けしていることを指示して直させたり、次フェーズに向けた調査のために指示をするなどの操作も行いますが、大まかにTaskelの開発フェーズの考え方はここまでで紹介できたと考えます。
※ 説明のため簡略化していますが、スキルは開発の発展に応じて追加変更がされており、実際にはもう数種類あります。前編のスクリーンショットに登場した quick-impl-deploy スキルは impl-phase-local, deploy-to-cloud を折衷したスキルで、頻繁なUI改善とユーザーフィードバックを得るために用意されたものでした。
バイブコーディングでもソフトウェア掌握力を下げないための「設計」ファイル
これまでの説明の中で、開発フェーズをAIが進める上で、一見必要がなさそうけど実は個人的に重要だと考えて残しているファイルが、設計をしたためたファイルである .ai/design.md です。
この文章を記述している時点でも、「設計」を文書化することについては否定的な意見をWeb上で若干目にしまして、それは筆者も理解できます。実際 .ai/design.mdは要するに backend/ と frontend/ フォルダを要約しただけのファイルです。AIにしてみるとソースコードと設計文書が二重管理になっています。
一般にAIはコンテクストに矛盾が入ると挙動が大変不安定になると言われています。今回で言うなら、backend/, frontend/ フォルダ内の実態と .ai/design.md 内の記述の乖離が起きると、AIの意思決定に大きな亀裂が入る、というリスクがあるはずです。今回のTaskelの手法では、ここであえて追加のコストを払って design-and-todos, consolidate-phase スキルなどでこのファイルを新鮮に保つということをしています。
開発者側の趣旨として言えば、この設計ファイルはどちらかと言えばAIのためではなく人のためにあります。AIに追加の(更新)コストを払わせてでも、人がパッと見て直感的に受け入れがたい設計や、不相応ないびつな実装箇所、全く知らない技術要素の採用がないかを俯瞰できることに価値をおくことにしており、今のところ筆者の立場ではそのコスト対効果は十分に大きい、ということです。
「作りたいもの」に集中できるように具体を(なるべく)分ける
ここまでは CLAUDE.md を起点にClaude Codeに最初に引き渡す基礎の情報について説明しました。これを前提として、筆者をはじめTaskelの開発関係者は具体的に開発指示を与えます。
大まかに指示の与え方は3つに大別されます。
- 新たな開発フェーズを requirements/phaseN.md ファイルを記述することで開始する
- .ai/logs/ 配下に「リクエストファイル」を記述して、それをClaude Codeにわたす
- 単にClaude Codeに指示する
2番目と3番目は直接指示という意味で本質的に変わるものはありません。3番目についてはすでに前編で「日本語の指示だけで完結する」という例として実行例を示しました。そこでここからは 開発フェーズを展開する流れについていくらか書いていきます。
Taskelの指示体系においては、理想で言えば「やりたいこと」を書く側では「要求」に関する説明をすればよく、具体的な手段の伝達にエネルギーを割かない(理想的にはゼロであってほしい)ものです。具体的な手段の最たるものがソフトウェア技術に類するもので、極端な話で言えば「paddingは8px」「認証情報はIdentity Aware Proxyを経由する際に得られるヘッダ情報を署名確認とセットで行う」といったもの。
CLAUDE.md の例に示したファイルのうち、以下の3つなどは明確にこの「具体的な手段」に介するガイドラインを提供しています。
- docs/auth-guideline.md … 実装するシステムが備えるべき認証認可機能に関するガイドライン
- docs/ui-design-guideline.md … WebフロントエンドのUIデザインに関するガイドライン
- docs/app-log-guideline.md … アプリケーションログ出力に関するガイドライン
※ここでは説明を省略しますが、 Claude Codeに組み込まれている rules を用いてPython固有のルールを backend/ に対して記載しておく、といったこともします。
今回の取り組みでは「技術の言葉が大幅に削がれた要求事項」を requirements/ という専用のフォルダにまとめています。前述した「おおむね100人規模」のようなシステム要求もここに1つのファイルとしてありますが、それを置いておくとTaskelというアプリケーションの達成したいことは大局的には requirements/fundamentals.md と開発フェーズごとの requirements/phaseN.md というファイル(それに例えば図表のための画像など)にまとめられます。
requirements/fundamentals.mdとrequirements/phaseN.md の住み分けというのは現時点ではかなり流動的であるため、今回の説明ではそこまで定まった説明をできる段階にありません。とはいえ大まかには
- fundamentals.md … より要求・願望寄りで制約条件寄り
- phaseN.md … 開発フェーズのゴールを決めるという意味で古典的な(要件定義の)要件寄りで手続き的
という雰囲気の違いがあります。以下に fundamentals.md の一部を示しましょう。
fundamentals.md
## ソフトウェアの中核となる情報

### このソフトウェアの目標

特定の組織内で作業者の日次目標・日報の管理を行なうシステムを実装します。

- 日次目標は概ね勤務開始時・作業開始時に記載され、その日の予定と利用可能な時間見積もりと作業予定を記録します

- 日報は概ね作業終了時・勤務完了前に記載され、実績を記述しつつ、予定が記載されていた場合には予実分析が出来るようにします

- 週単位、月単位で予実を把握できるべきです。ただし、日単位の管理ほどに細かい調整はこの単位で行なう想定はありません。

  主たる関心は「やや長い期間を見据えつつも日次の行動を当事者で掌握できるようにすること」にあります

  長期の目標管理のための仕組みではありません

作業者の状況を、管理者および作業者本人が許可した閲覧者(個別ユーザーまたはグループ)が閲覧できるようにします。

閲覧権限は「管理者が設定したもの」と「作業者本人が設定したもの」を区別し、作業者本人は管理者が設定した閲覧者の削除・変更はできません。

(自分の同僚を自分で追加することは可能)

閲覧者は対象ユーザーのカレンダー(予定・実績)を読み取り専用で閲覧できますが、タスクの作成・編集・削除はできません。

閲覧者は各タスクに対してコメントの投稿が可能で、コメントには投稿者と投稿日時が表示されます。

コメントは投稿者本人と管理者が削除可能です。

...
おおむね、日本語で「これをやりたい」と書いてあるのであって、それを実現するいわゆる「機能要件」を詳述したものではないことは読み取れると思います。これを記述している段階では、レイアウトのイメージも固まっていませんでした。実際、上の指示には「ボタンをどう配置するか」のようなものは一切なく「タスクで何をしたいか」といったぼやっとしたことしか書いていません。
「囲い込む」ような指示をなるべく取り入れつつ
進化の激しい現代において、AIへの指示の仕方が変わっている中であえて主張するなら、2026年半ば時点のAIではすでに「XXXしなさい」という直接的な指示ではなく「こういう状態であってほしいが、どうか」とする方がうまくいくケースが増えているように思います。
それを受けて、自分が実現したいことに「技術用語を羅列した具体的な手続き」ではなく、「最終的にアプリケーションで実現されていたい状況」を記述していくと、自ずと「囲い込む」ような指示になっていくように思います。ここで「囲い込む」という表現は、普通のソフトウェア開発ではあまり使用しない感覚ですが、ソフトウェア開発で言えば「手続きではなく制約条件を記述する」という表現にやや近いかもしれません。
なぜ「囲い込む」方がうまくいきそうに感じるかについて。端的に言えば、昨今のLLMの方が私より知っている事情が多いからです。「XXXしなさい」と指示すると、AIが本来知っている事情を全部すっ飛ばして私の指示に従ってくれこそしますが、私が忘れているか、そもそも知らない・理解していない重要な技術的制約なども置いてけぼりにすることがしばしばあります。
制限を大量に渡して、かつLLMが知っている世界全体から拾われる共通の制限を念頭に、全ての手法からもっともよさそうなものを選ばせる、という緩いアプローチの方がLLMのポテンシャルを引き出せるのではないか。
これは、現時点であくまで開発当初を振り返って見返した場合、なのですが、前掲のrequirements/fundamentals.md の冒頭部分は、とりわけこのスタンスが強く出ていると言えます。
現実には「囲い込んだり」「指示したり」両方
ただそれでも「コメント」は古典的な紙のカレンダーや手帳と比べればソフトウェア技術を意識せざるを得ませんし、上記の指示に続く以下の箇所ではGoogle Workspace、カレンダーインポート、SendGridと、結局はバリバリの技術用語での指示が連続しているのが以下の続き部分で見て取れます。
fundamentals.md 続き
...(上記の続き)

### あるべき機能

前提として、組織横断で管理・共有できる「プロジェクト」を管理出来るべきです。

またIT企業の工数管理で期待されるような管理会計のプロジェクト分解が出来ることを期待します。

直接工数(ソフトウェア開発、テストなど)・間接工数(ミーティング)・その他(休憩?)について

作業者が工数種別を選択して特定の時間帯にそれを割り当てられるべきです。

Google Workspace (Google Calendar) を介して個別のカレンダーインポートが出来るべきです。

このアプリケーションではGoogle Calendar API等を介した自己の予定の引込みを行えれば良く、逆方向の「書き出し」は想定してません。

Webブラウザ上でドラッグ等を通じて予定を伸縮、予定を移動できるような操作性を特に日次の管理では出来るようにします。

日次目標と日報には本人のコメントと、閲覧者からのコメントを受け付けます。

然るべきメール送信設定(SendGrid)がされている場合、関係者にメールが送信されるようにします。
最終的に作るソフトウェアが「Webアプリケーション」であること、またその中に「電子メール」のようなインターネット固有の機能がある以上、実現したいことと技術的制約・技術要件を完全に分離するということは流石にできないときがあるのですが、とはいえ基本的な考え方として「分離を好むし、先に分離できるならしておく」という発想はチャレンジするに値する、と考えています。
ここで続けて、Taskelの開発スタイルで requirements/fundamentals.md の直後にあたる Phase 1の指示 requirements/phase1.md を見てみます。これは、前掲の fundamentals.md で達成したいアプリケーションの方向性を規定後、最初のMVP (Minimum Viable Product) を構築する開発の第一段階 (Phase 1) で満たす条件を記述したものです。
phase1.md
# Phase 1 の要求

最初の開発段階であるPhase 1で求められる機能の外郭を示します

## 社員を登録し管理できる

- 社員とユーザーを同一視して問題ありません

- 社員には少なくとも user_id, メールアドレスがあり、認証要素としても使用します

- 社員に上司を1名以上設定可能とします

- Django Admin権限とは別にこのアプリケーションの管理者を指定可能とします

  区別するため Django Admin (superuser) はシステム管理者と呼びます

## 管理者がプロジェクトを管理できる

- プロジェクトの前提条件となるプロジェクト管理機能を実装し、(アプリケーション)管理者が追加・編集を行えるものとします

- 既に使われているプロジェクトは物理削除出来ないようにします。代わりに有効・無効は設定できるようにします

- プロジェクトには管理会計上の指標となる情報を付与できるものとします

## 日次目標と日報を記載できる

- `requirements/fundamentals.md` に基づく全ての機能を実装します

- 週次・月次の目標、週報・月報を記載できるとより望ましいです

- コメントはテキストのみとします。Markdownや添付ファイルは不要です

## 上司は部下の日次目標・日報(週報・月報等)を横断で把握できる

- 上司は部下の日次目標における工数情報や詳細、日報、週報、月報の提出状況と統計情報を把握できるものとします

- 統計情報とは例えば間接工数割合などです

... (社内の事情に関わる部分)
fundamentals.mdと比べると直接的な指示に近い内容が大幅に増えていることが見て取れます。
とはいえ、ここでも、例えば「機能の外郭を示します」とあるところなどに「囲い込む」指示が強く意識されています。手順の言葉である「ユーザー管理はこのようにしてください」といったことをなるべく避ける意識が働いています。
参考までに、次の指示はTaskelではなくその後続の取り組みでの例なのですが、これも筆者として「囲い込む」指示にさらに踏み込んだ事例です(おおむね期待した通りの進め方をしてくれました)。
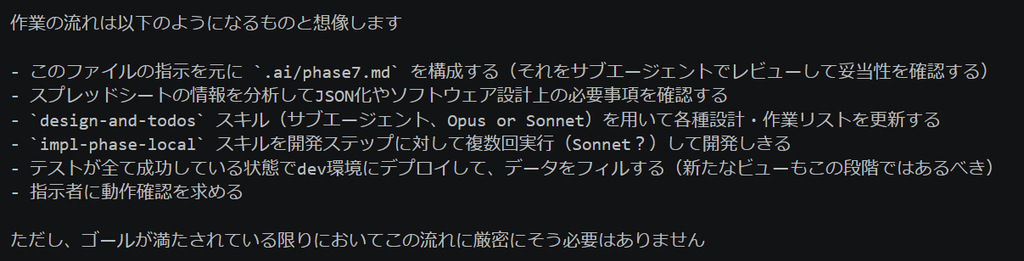
こちらは「この順序でやってください」とは指示していません。ここでどのようなデータを投入するかの具体はさておき、元のデータをJSON化しておく処置をどこに置くのが最良か、私もパッと一択では定まりませんでした。設計の初期時点でExcelシートを分析してしまうのも、最後にそれをやっても構いません。順序はどちらでも辻褄が合います。そこで「ゴールが満たされているならどの順序でも良いが、こういう進み方を指示者は想定している」という指示はします。
※ AIへのコンテクスト・プロンプトでの違いは技術的・理論的なことというよりは、多分、気持ちの上での違いの方が大きいでしょう。制約条件とは数式的で堅固堅牢な論理的境界線を意識させるものですが、一方ここでのAI指示の「囲い込む」とは「元気の良いペットのワンちゃんを思う存分走り回らせたいが、行ってはいけないところは十二分に教えておきたい」というニュアンスです。
ソースコードは普段見に行かなくても想像ができるようにはしておく
backend/ と frontend/ はそれぞれ名前の通りWebバックエンド(REST APIの側)とWebフロントエンドに対応します。
このフォルダ内のソースコードを人が見に行くということはほとんどのケースではありませんし、前述の通り記憶の限りで編集を行ったことはなかったように思います。
ただ、見に行くことがないことと、把握していないことはここでは異なります。 .ai/design.md を眺めつつ、大まかなフォルダ構成や重要なファイルのありどころ、インストールしている第三者ライブラリなどを把握する必要はあります。
具体的に言えば、backend/ にはDjangoのプロジェクトが丸々収められており、uv を使って特定のPythonバージョンとそれにインストールされるパッケージの情報が同フォルダに収められており、そのリストはXXXというファイルを見ればわかる、ということくらいはすぐに分かるくらいには把握しておくべきだと思いますし、さらに踏み込んで、例えばタスク管理時に呼び出されるREST APIの大まかな設計も分かっているべきです。
体系的なテストの多重化
以上、Taskelで試用しているClaude Codeのコンテクストの使い方、指示のスタイルについて記述しました。将来のLLMの性能においてこの仕組みをそのまま使用すべきとは思っていませんが、現時点でデプロイが安定する組み合わせにはなっているように思います。
ここまでの説明では抜けていながら、ソフトウェア品質を決定的に上げた工夫があとひとつだけあるので、それを紹介して最後ということにします。 docs/test-guideline.md においてテストを立ち位置に応じて3重で構成するように指示している部分がそれです。
- ユニットテスト
- 特にWebフロントエンドとWebバックエンドの結合テスト
- Webブラウザを介して行う自動化されたE2Eテスト
※ また、不定期ではありますが、記載済みの要求事項などを見返しさせて、現状の機能がそれを満たしているかをレビューベース、もしくはより包括的な総合テストチックな操作(E2EテストとDBなどの確認。社内ではよく「シナリオテスト」と呼んでいます)でも確認します。
この多重テストはごく一般的なテスト設計に登場する用語であると同時に、バイブコーディングをこなすAIエージェントの視野が狭まるところに対する意識的な手当として意識的に設定しています。つまり「顧客の方向から見て動いてます?」という目線でのテストをV字モデルの各所で行うイメージとでも申しましょうか。開発者としてのAIが「良い」と思っていても、コンテクストを異にする顧客としてのAIが「ノー」と言ったらダメ。
アプリの開発の型としての Taskel Framework も作った
今回紹介したTaskelのAI向けコンテクストは、過去数回のチャレンジの中でも個人的には別格で「手放し」で開発できた印象がありました。
そこで以降、同じようなパターンで 「使いたいアプリの形」だけ指示すればアプリができて、社内の関係者に共有できるという状態そのものをパターンとして使っていきたいなぁと考えました。正確に言えば順序はやや逆で、もともとそうしたいと思っていくらかチャレンジしていた中で、Taskelは偶然、非常に上手く行きました。
そこで、アプリ本体説明を抜き取った雛形 Taskel Framework を抽出しました。Taskelの実装本体である Webフロントエンド・バックエンドの実装が保存された frontend/, backend/ フォルダの中身全てと、要求事項をまとめたrequirements/ フォルダにあるタスク管理に関する記述を大部分削除して、他のアプリでも必要な社内の制約などは自然にAIが読み込むように工夫をすることにしました。
- CLAUDE.md は必ず読まれる。そこに「こういうときはこの資料を読む」といったガイドラインを書く。
- 設計・開発・整理といった典型的な手順をスキル化する。
- 一部のファイルにおいて rules を設定して、例えば「Pythonコードを編集するならフォーマッタはこれを使うこと」といったことを念押しする。
このフレームワークを元に現在に至るまでにさらにいくつかのソフトウェアプロトタイプを作るに至っています。
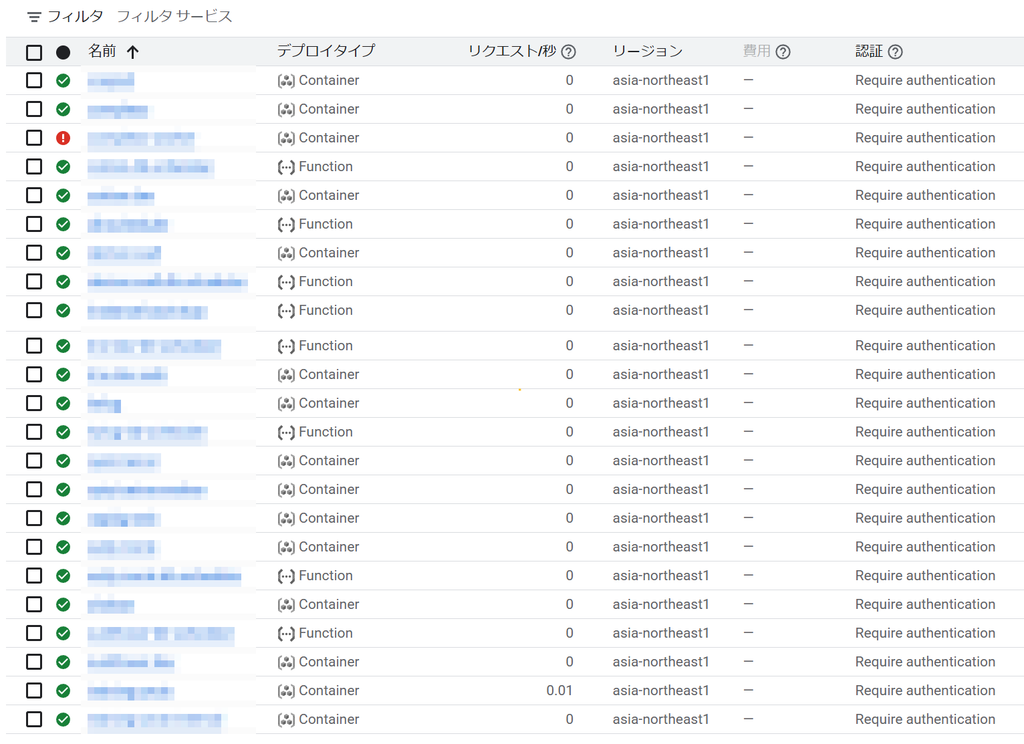
具体例で1つ挙げるなら、RSS社内の技術研修のパートを大整理するというチャレンジをしており、そこでも活躍しています。
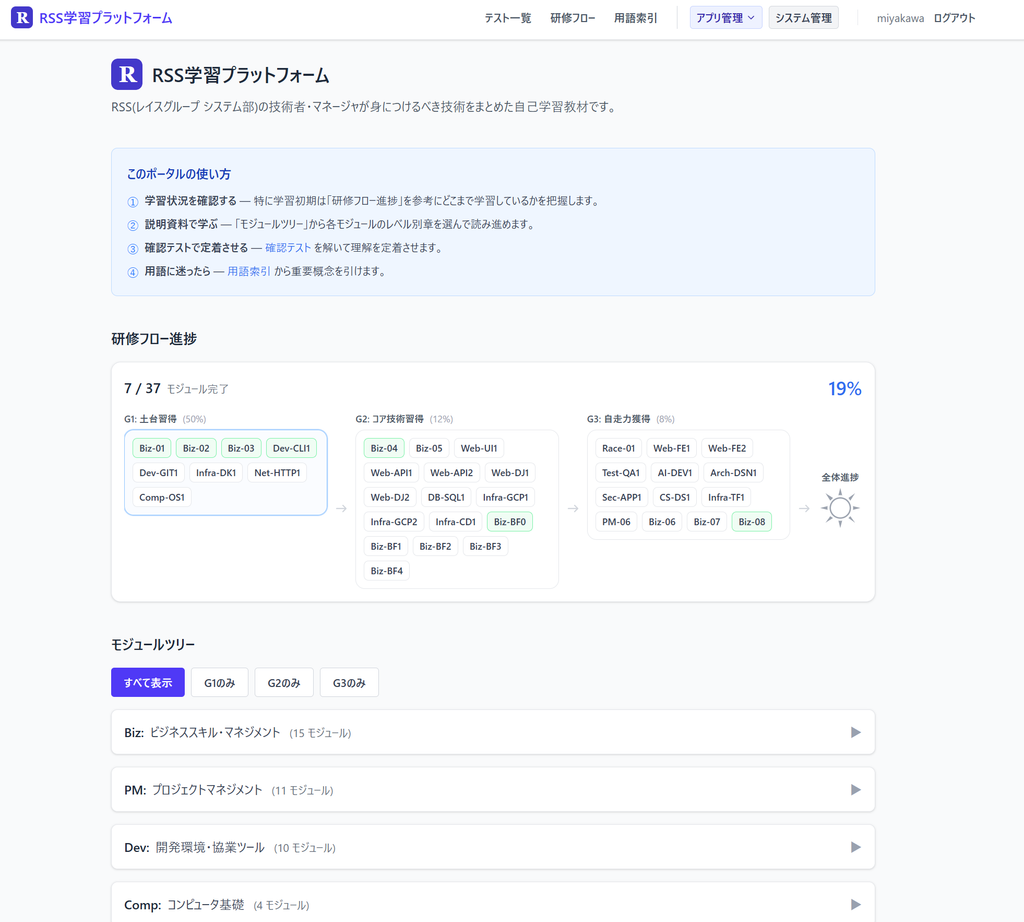
このソフトウェアでは研修の骨子、内容を非常に幅広くAIに作らせつつ「いかにAI臭さなく、本物の研修として扱えるか」といった論点を重視してコンテンツの内容を整理しています。その中にしれっと「作文問題のAI自動採点」などの機能を入れ込むことで、これまでになかった研修の合理化も含めています。
今回の文脈では何よりも、そのソフトウェア外郭についてTaskel同様に私がほとんど全く手出しをしていない、ということが重要です。Google Cloudを基点に採用している基礎技術 (Cloud Run, Cloud Storageなど) は全く変更はなく、よって管理体系についてクラウドインフラチーム(これも私が見ている分野なんですが)が混乱をきたすということもない状態でプロトタイプ検証を続けていられるという状態は大変望ましいものです。
Taskel Frameworkは停止したプロジェクトを再起できるか
ここまでで次のような話の流れがあります:
- 不本意にも途中で中断されてしまったプロジェクトについて紹介しつつ、その原因についても想像を巡らせました。
- Taskelでは類似の問題がそもそも起きないように工夫しており、ある程度の成功が見てとれます。
- そしてその工夫をTaskel以外に利用できるように Taskel Framework として抽出しました。
この話の流れを延長してTaskel Frameworkを活用すれば、バイブコーディングを用いた開発プロジェクトにおける「頓挫」の原因も解決できるかもしれない、と期待するのは自然に思えます。
理想的な比較をするのであれば、前掲の停止したプロジェクトの当事者の方にTaskel Frameworkを直接使ってもらい、Taskel Frameworkによって障害が取り除けたかを直接評価してもらうのが最良の試金石になるはずです。とはいえ、私が勝手にそこまで強いるのはそれはそれでハードルが高い。
代わりに当時のプロジェクト資料をもとに私の方で改善後のプロセスを試して見ることにして……Taskel Framework で改めてプロトタイプを作ってみました。
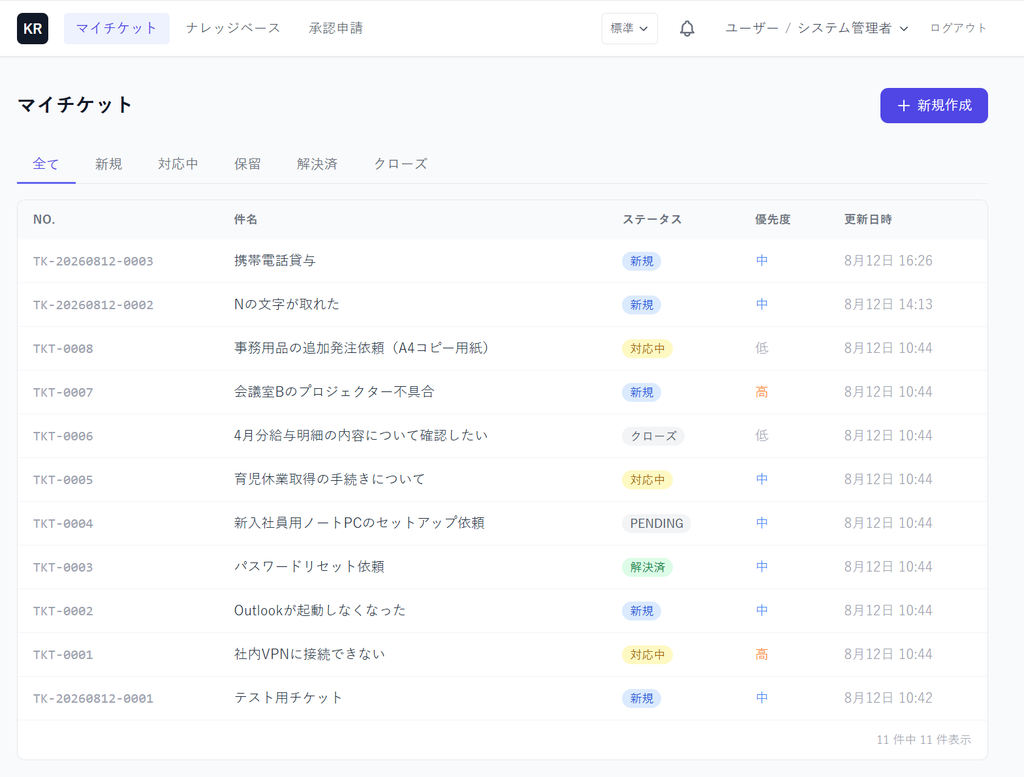
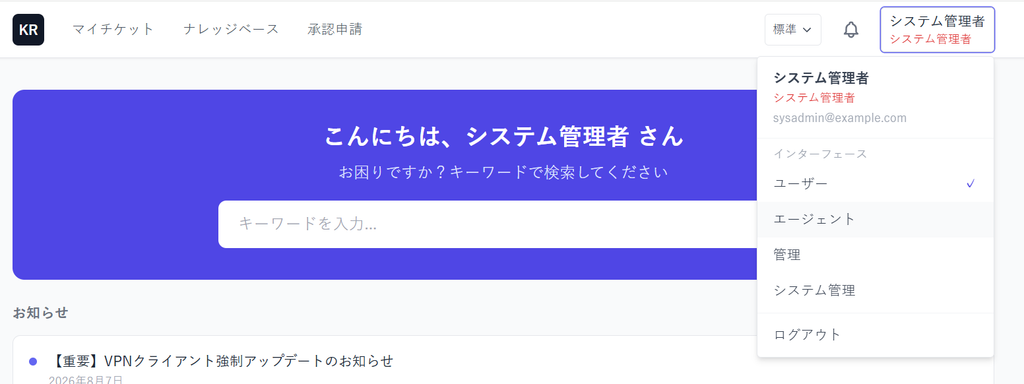
スクリーンショットから分かる通り、当該業務とは「問合せ対応」業務とそのナレッジベース管理ツールに関わるものです。Taskel同様、画面上に登場するUI要素はモックの類ではなく、実際に動作するSPAのWebアプリケーションです。
今回のプロトタイプは Taskel Framework 由来のため、Taskelとほとんど全く同じ座組でデプロイしています。Google Cloudへの展開は同じように行われ、私の方で試行錯誤する部分はほとんどありませんでした。元のプロジェクトがデプロイに苦労していたのと比較するなら、これだけでも格段の進歩と判断できます。
「以前の取り組みで達成し得なかった共通の試用環境がすぐにできた」というのは事実でTaskel Frameworkの問題解決力に自信を持てるものの、本番運用していくにあたっての論点はがぜん山ほどあります。例えばヘッダメニューやそれを介したユーザーの導線のような部分を私は全く知らないため、利用者目線で議論をする(≒要件定義をする)ことは避けられません。前掲のスクリーンショット時点では課題があったため、すぐに日本語指示により次のように切り替えたりと、このあと試行錯誤は継続します。
この記事を書いている時点では、中断したプロジェクトの代わりに先述のソフトウェア(プロトタイプ)が採用されているということはありません。よって、前掲の2つの目標のうち、2つ目が達成されたとはいえ、1つ目が成り立っていません(そしてそちらのほうがエンドユーザー目線で言えば本質的なのです)。
ただ、このプロトタイプを元に新たに同種の企画を立て直すという提案は肯定的に評価されており、今のところ「蘇る」可能性が増しています。もし取り組みとして続くなら、今回は停止せずにリリースにこぎつけたいところです。
LLMとバイブコーディングの力を正しく引き出す「設計とコンテクストの枠組み」。これが機能すれば、ソフトウェア開発の速度と確実性は、これまでとは全く違う次元に到達するはずです。
後編ではAI時代の開発者の新たな役割について考えます。
レイスシステムソリューションズ株式会社のソフトウェア開発や、
採用に関するお問い合わせについては、下記のリンクにてお問い合わせください。